总体学习计划
- 目标
- 从零系统学习机器学习与强化学习,能自己设计并训练强化学习策略(奖励设计、PPO、域随机化、sim2real),在 MuJoCo 仿真中训练 Microduck 双足小鸭行走,实体鸭到货后部署上去
- 验收标准
- 仿真中 Microduck 平地稳定前行 20 秒不摔、速度跟上指令、3 个随机种子都成功;加 20 ms 控制延迟和侧向推搡后仍能走;能独立解释并调 PPO;有可用的策略导出和部署脚本
- 截止
- 2027-01-04
- 每天
- 每天 2 小时
- 落后时砍掉
- 落后时依次砍:1 手写 PPO 改为读懂库的源码;2 Q-learning 代码实现改为只做交互图;3 并行训练改为本地少量训练;4 鲁棒性测试只保留延迟和推搡两项
每日进度:4 / 15 天(27%)
章节
章节进度:1 / 9 章(11%)
| # | 章节 | 难度 | 主要内容 | 天数 | 目标 / 完成标准 | 状态 | 互动页 |
|---|---|---|---|---|---|---|---|
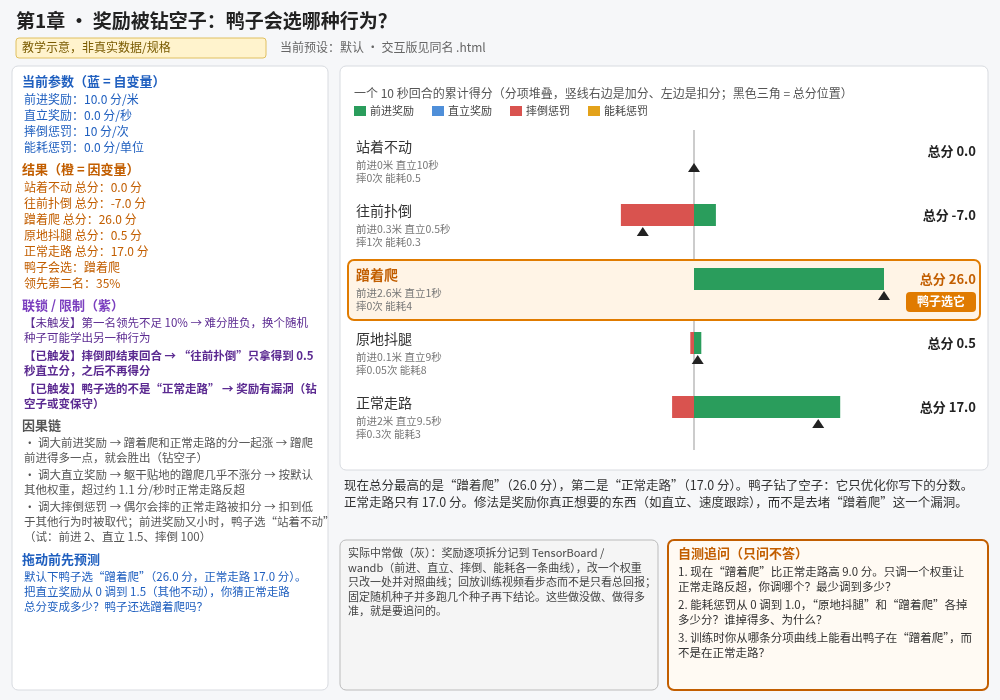
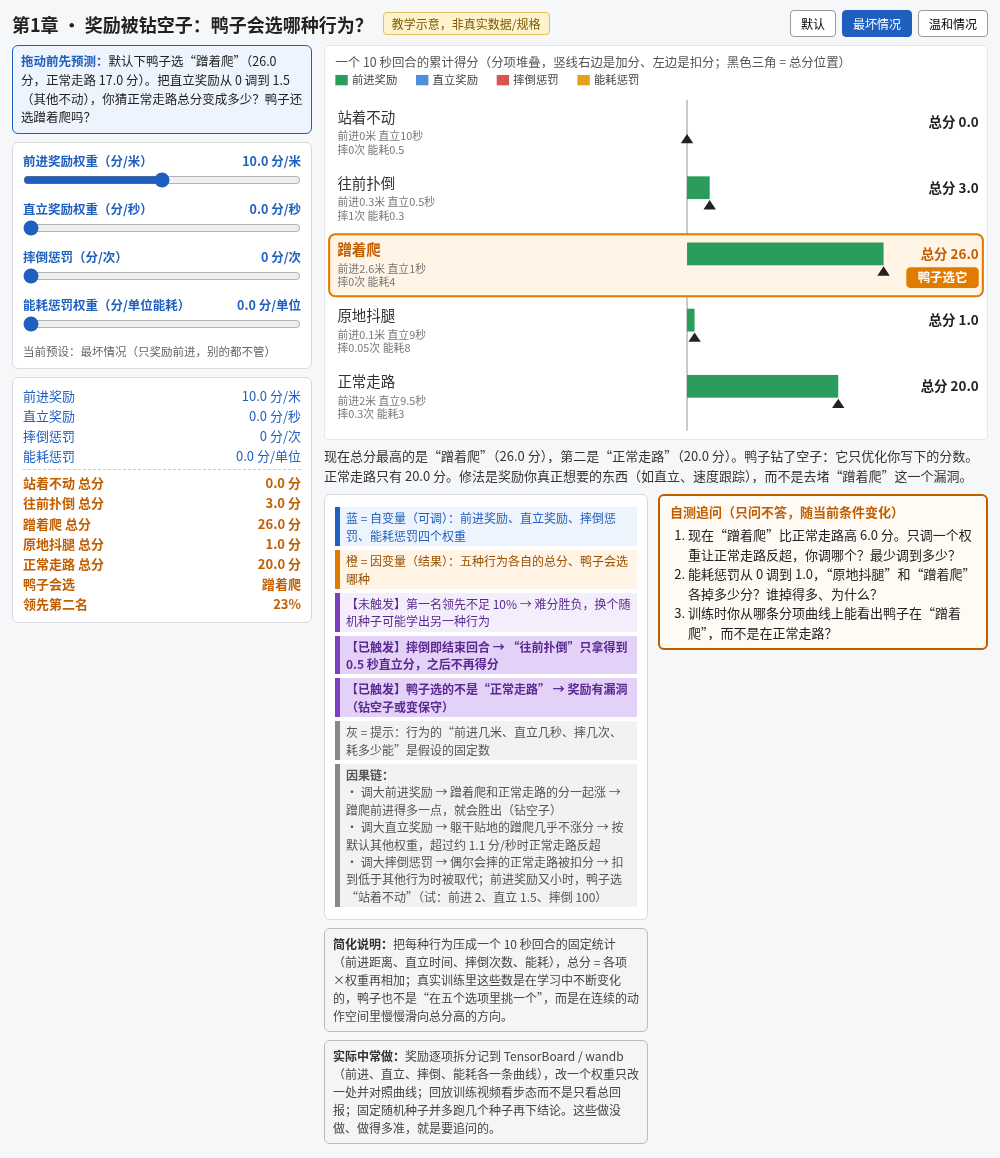
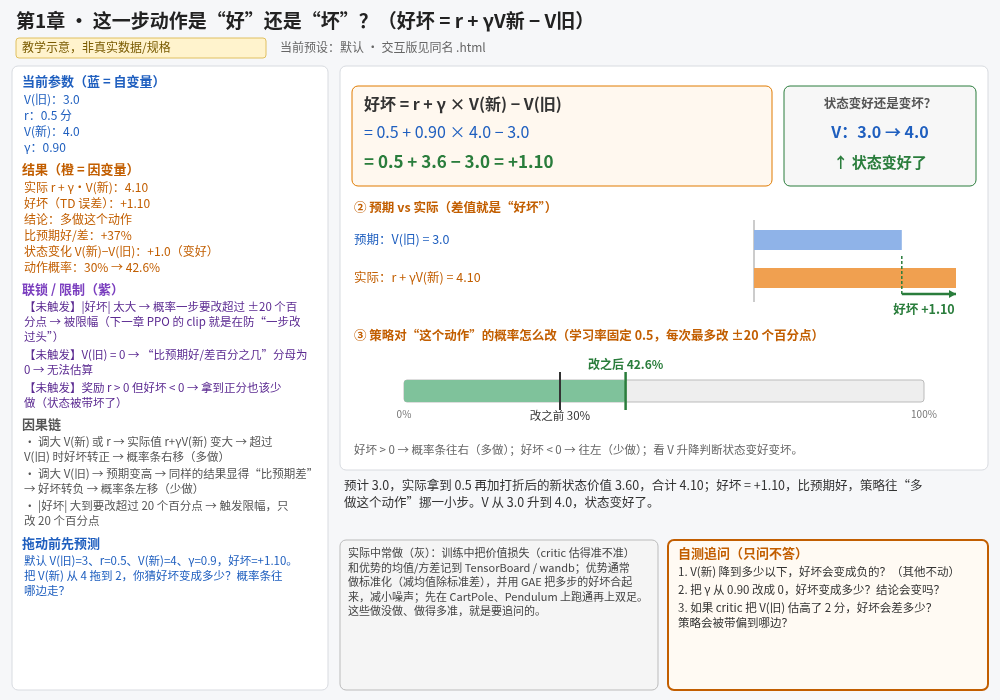
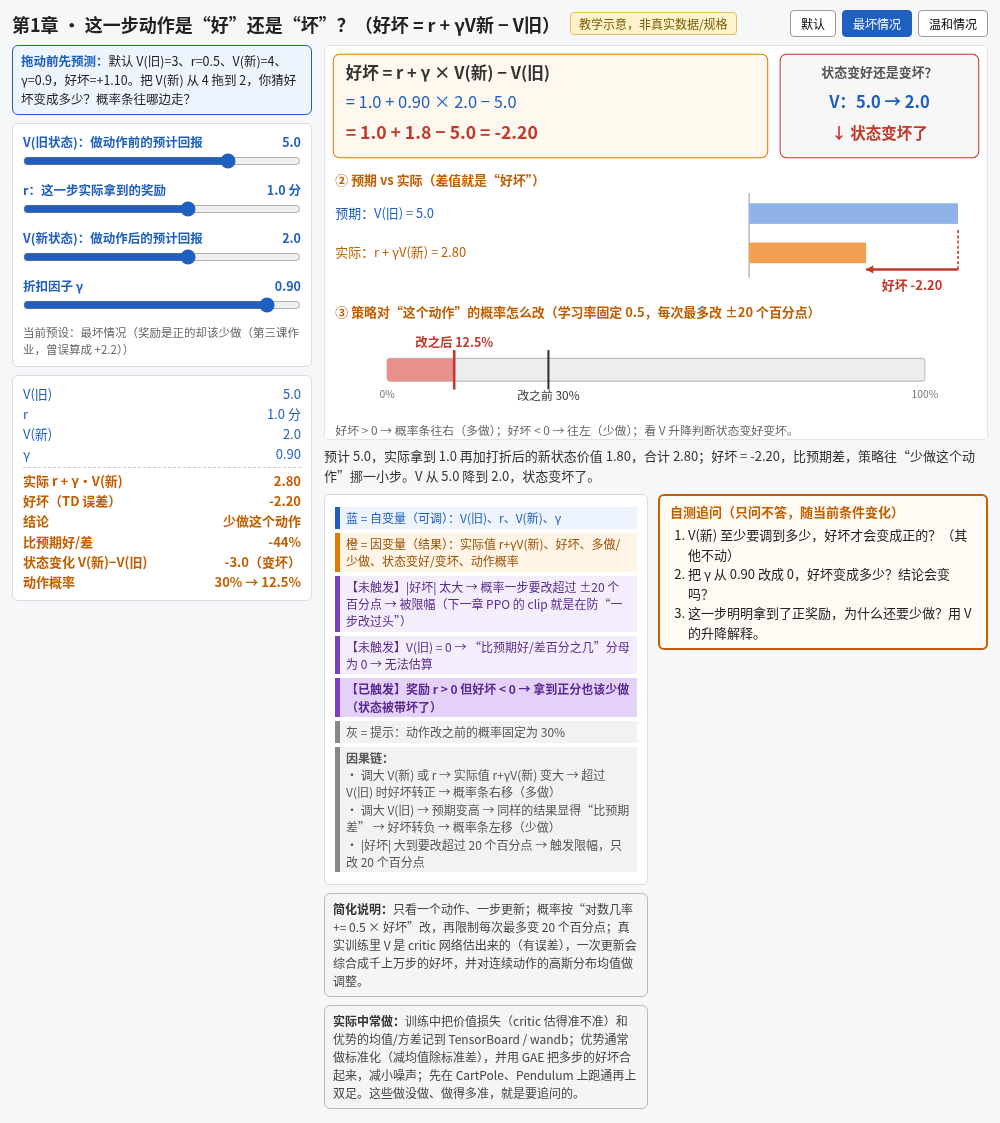
| 1 | 第1章 强化学习基本概念 | 入门 | 4 | 理解状态、动作、奖励、回报与折扣、策略与价值、探索与利用 完成标准:阶段小测通过(已于 2026-10-02 通过) | 已完成 | ch1-reward-hacking ch1-discount ch1-td-advantage ch1-explore-exploit | |
| 2 | 第2章 Python、NumPy 和数学摸底补课 | 入门 | 5 | NumPy 数组运算、概率与期望、导数与梯度 完成标准:能用 NumPy 算出一段回报;能手推一个简单函数的梯度 | 进行中 | 数组形状与广播(待做) 折扣权重与代码对照(待做) 采样平均收敛(待做) 梯度下降小球(待做) 链式法则计算图(待做) | |
| 3 | 第3章 机器学习与神经网络 | 进阶 | 8 | 损失函数、梯度下降、PyTorch 自动求导、过拟合 完成标准:用 PyTorch 从零训练一个小网络并能解释损失曲线 | 未开始 | 线性回归与损失(待做) 学习率对梯度下降的影响(待做) 观测→网络→动作结构图(待做) 过拟合与验证曲线(待做) | |
| 4 | 第4章 经典强化学习 | 进阶 | 8 | MDP、贝尔曼方程、价值迭代、Q-learning 完成标准:在网格世界中手算并用代码算出价值和策略 | 未开始 | MDP 价值网格(拖 γ 和奖励看价值与策略箭头)(待做) 价值迭代分步(待做) Q-learning 探索率对比(待做) | |
| 5 | 第5章 策略梯度和 PPO | 高阶 | 12 | REINFORCE、优势、actor-critic、GAE、PPO clip 完成标准:stable-baselines3 跑通 CartPole 和 Pendulum,再自写 PPO 跑通 | 未开始 | 策略梯度直觉(动作概率随优势上调下调)(待做) GAE λ 权重(待做) PPO clip 示意(待做) 学习曲线对比(超参与种子)(待做) | |
| 6 | 第6章 MuJoCo 仿真入门 | 高阶 | 8 | 模型文件、关节和电机、Gymnasium 环境封装 完成标准:自己封装 MuJoCo 环境并训练倒立摆成功 | 未开始 | 关节 PD 控制响应(待做) 倒立摆状态与控制(待做) 观测与动作归一化和限幅(待做) | |
| 7 | 第7章 Microduck 双足行走训练 | 高阶 | 14 | 观测与动作设计、奖励设计、并行训练、调参 完成标准:仿真中平地稳定前行 20 秒不摔,速度跟上指令,3 个随机种子都成功 | 未开始 | 奖励分量堆叠图(待做) 观测与动作设计结构图(待做) 步态相位与参考动作(待做) 训练前后对比(待做) | |
| 8 | 第8章 鲁棒性和 sim2real | 高阶 | 8 | 域随机化、延迟、噪声、推搡测试、导出策略 完成标准:加 20 ms 延迟和侧向推搡后仍能走;部署脚本就绪 | 未开始 | 域随机化参数范围(待做) 控制延迟对稳定性的影响(待做) 推搡恢复测试(待做) | |
| 9 | 第9章 实机部署 | 高阶 | 0 | 实体鸭到货后部署策略 完成标准:真机上能走起来(天数机动,约 2027 年 1 月初) | 未开始 | 部署检查流程图(待做) |
每日路线
| 天 | 内容 | 说明 | 状态 | 级别 |
|---|---|---|---|---|
| 1 | 强化学习在干什么:智能体、环境、状态、动作、奖励 | 2026-10-02;配图 ch1-reward-hacking | 已完成 | 入门 |
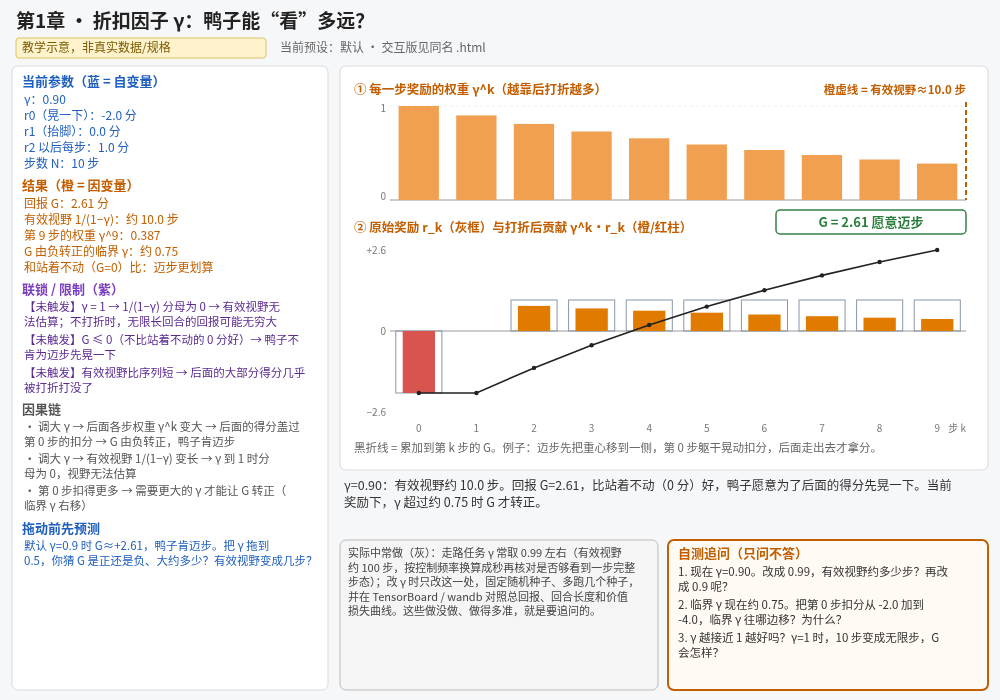
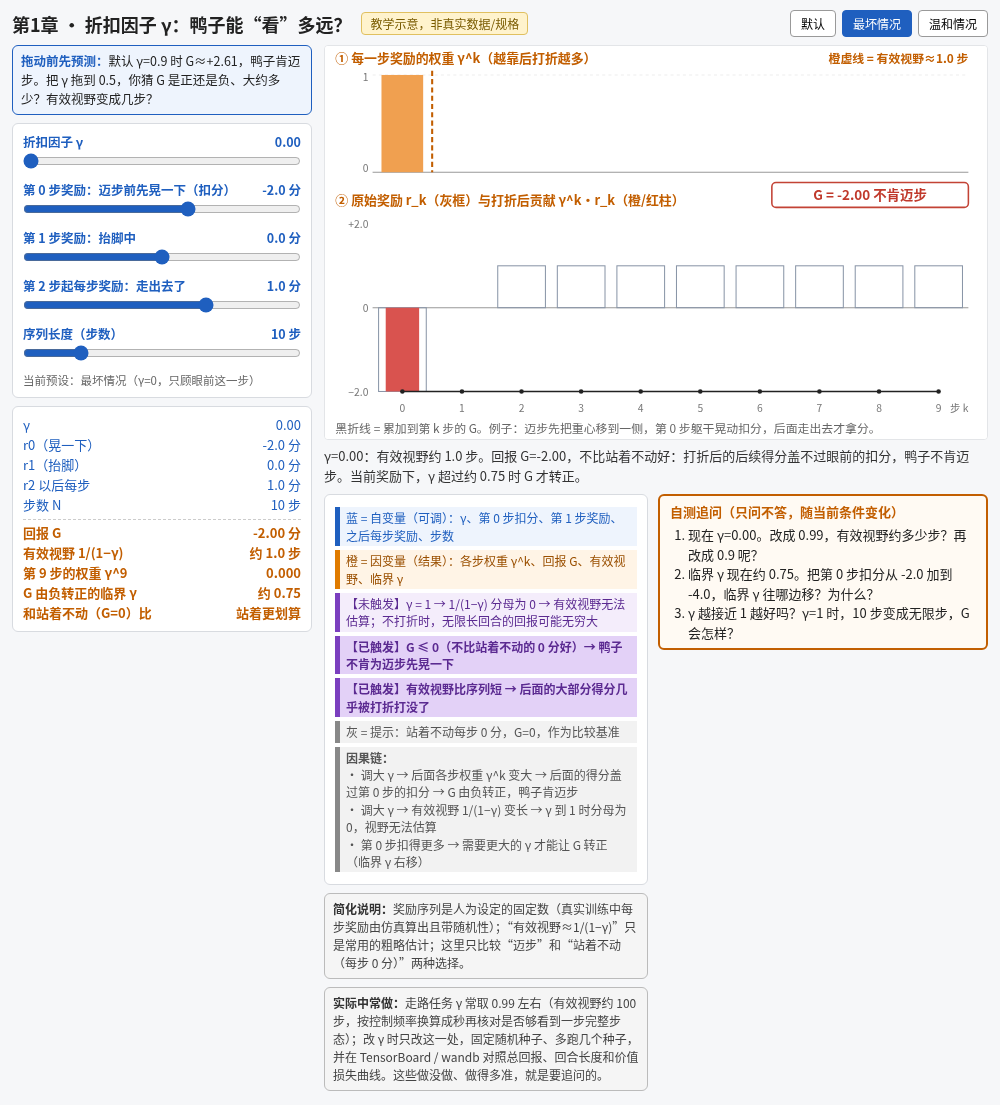
| 2 | 回报与折扣因子 | 2026-10-02;配图 ch1-discount | 已完成 | 入门 |
| 3 | 策略与价值函数,好坏 = r + γV新 − V旧 | 2026-10-02;配图 ch1-td-advantage | 已完成 | 入门 |
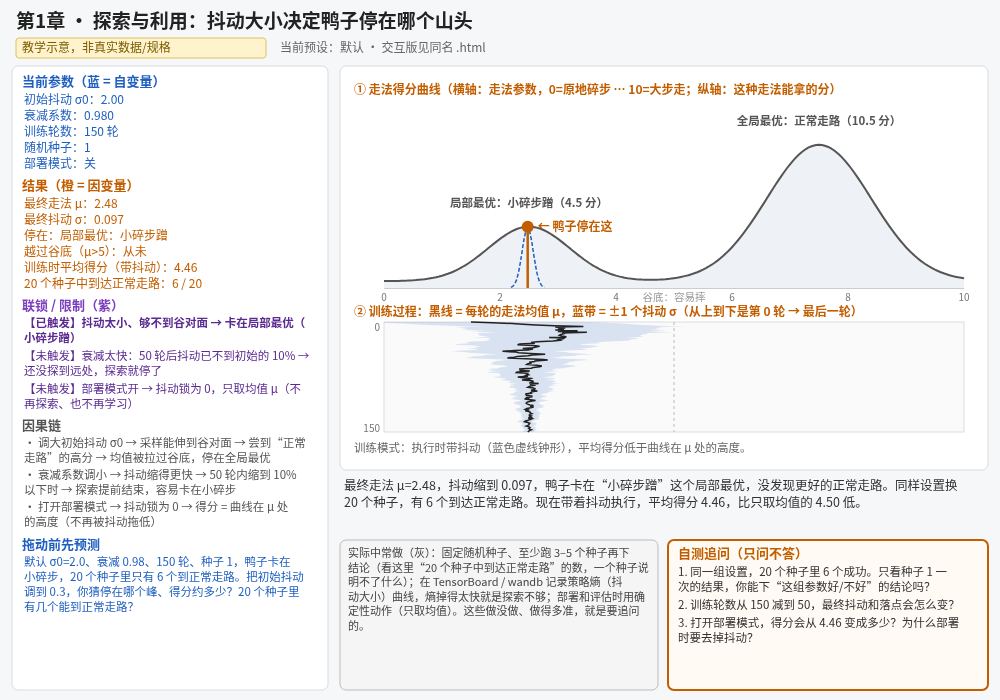
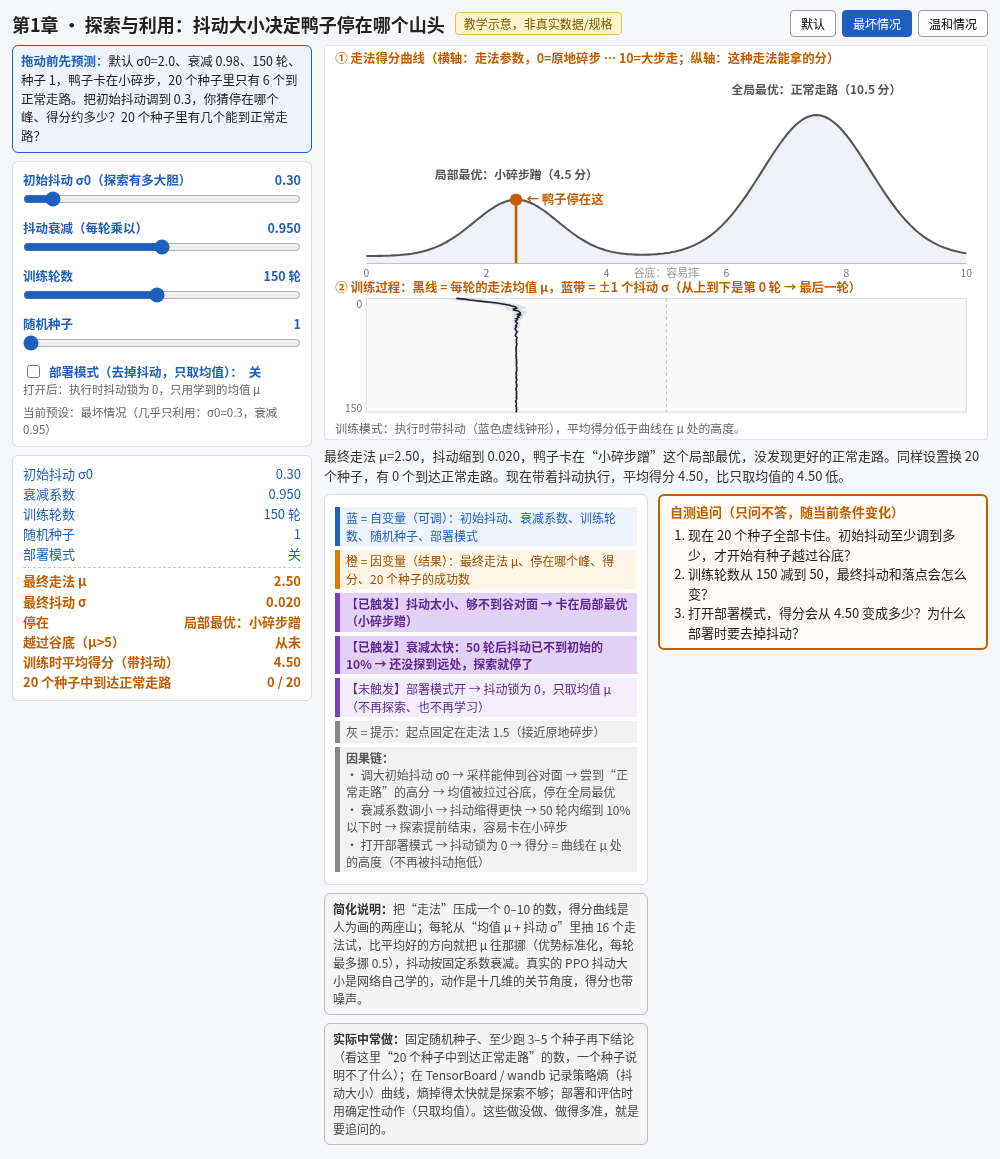
| 4 | 探索与利用 + 阶段小测 | 2026-10-02;配图 ch1-explore-exploit;小测通过 | 已完成 | 入门 |
| 5 | Python 摸底与 NumPy 数组基础 | 10/3;配图 数组形状与广播 | 未开始 | 入门 |
| 6 | 用 NumPy 向量化计算回报 | 10/4;配图 折扣权重与代码对照 | 未开始 | 入门 |
| 7 | 概率与期望:采样平均 | 10/5;配图 采样平均收敛 | 未开始 | 入门 |
| 8 | 导数与梯度 | 10/6;配图 梯度下降小球 | 未开始 | 进阶 |
| 9 | 链式法则 + 第 2 章小测 | 10/7;配图 链式法则计算图分步演示 | 未开始 | 进阶 |
| 10 | 第 3 章 机器学习与神经网络(逐日路线开章时补) | 10/8–10/15 | 未开始 | 进阶 |
| 18 | 第 4 章 经典强化学习(逐日路线开章时补) | 10/16–10/23 | 未开始 | 进阶 |
| 26 | 第 5 章 策略梯度和 PPO(逐日路线开章时补) | 10/24–11/4 | 未开始 | 高阶 |
| 38 | 第 6 章 MuJoCo 仿真入门(逐日路线开章时补) | 11/5–11/12 | 未开始 | 高阶 |
| 46 | 第 7 章 Microduck 双足行走训练(逐日路线开章时补) | 11/13–11/26 | 未开始 | 高阶 |
| 60 | 第 8 章 鲁棒性和 sim2real(逐日路线开章时补) | 11/27–12/4 | 未开始 | 高阶 |
章节笔记
图与动画
互动页
- ch1-discount.html(可直接打开,或下载后用浏览器打开)
- ch1-explore-exploit.html(可直接打开,或下载后用浏览器打开)
- ch1-reward-hacking.html(可直接打开,或下载后用浏览器打开)
- ch1-td-advantage.html(可直接打开,或下载后用浏览器打开)